本地部署诊断AI:行为一致性把关,49%病例自主处理准确率98.9%
德累斯顿工业大学团队在Nature Medicine发表完全本地化部署的医疗AI智能体:七病种诊断准确率90.04%,接近云端基线;以行为一致性为可靠性信号,49.4%病例可安全自主处理,这部分诊断准确率达98.9%。
核心要点
- 问题:医疗AI要进入临床,横着两道坎——敏感的医疗数据必须留在机构内部,不能外传云端;医生还要能判断AI给出的诊断到底可不可信。
- 方法:德国德累斯顿工业大学团队构建一套完全本地化(on-premise)部署的诊断AI智能体,在基于MIMIC-IV的两个基准上评估,并系统比较了多类"决策时可靠性信号"。
- 结果:七病种基准上本地模型诊断准确率90.04%,接近云端基线90.7%;行为一致性(同一病例多次运行是否给出相同诊断)是区分对错最可靠的信号(AUC=0.860)。
- 意义:以行为一致性0.90为闸门,可保留49.4%低风险病例自主处理、准确率98.9%,其余转医生复核,为"选择性自主"提供了可操作的量化框架。
- 原文:On-premise medical AI agents for reliable clinical decision-making,Nature Medicine,2026-09-15
1. 本地部署诊断的临床挑战:数据主权与"信不信任"两道坎
大语言模型处理复杂医疗任务的能力越来越强,但要真正走进临床,仍被两件事卡住。第一是数据主权(data sovereignty):病历、检验值、影像这些高度敏感的健康信息,机构往往要求留在院内、不能发送给外部云服务,这直接排除了依赖云端API的方案。第二是可靠性判断:即便AI能给出诊断,医生仍缺乏手段去判断"这一次的结果值不值得信"——一个偶尔出错却从不"示弱"的系统,比一个准确率略低但会主动说"我不确定"的系统更危险。
此前的研究(如自主EHR智能体MIRA)已经证明,自主医疗智能体在模拟环境下能完成全流程诊疗、准确率超越专科医生。但那类工作大多依赖云端模型,且没有回答一个关键问题:系统何时可以放手自主,何时必须交给医生。德累斯顿工业大学的这项研究,正是把火力对准了这两个未解之题。
2. 本地部署智能体的核心创新:把"可信度"变成可计算的信号
研究由德累斯顿工业大学Else Kröner Fresenius数字健康中心(EKFZ)Jakob N. Kather团队主导,海德堡大学医院国家肿瘤疾病中心参与。系统建立在2026年6月发布的MIRA智能体框架之上,创新集中在三点。
第一,全链路本地化运行。模型推理与全部数据处理都在机构自有的本地基础设施上完成,用的也是开源权重模型(如Qwen-3.5、GLM-4.5-Air、GPT-OSS),跑在NVIDIA H200、RTX PRO 6000这类本地GPU上,为数据治理、版本与权限管理提供了技术底座。
第二,用"行为一致性"度量可信度。团队系统比较了三类决策时信号——模型内部似然、语言类信号、行为稳定性(同一病例多次运行是否给出相同诊断),发现行为一致性最能区分正确与错误诊断,而模型自报的概率分数反而不可靠。
第三,提出"选择性自主(selective autonomy)“框架。不追求全自动,也不要求每条都人工核验,而是用可靠性信号做闸门:高一致性、低风险病例交给AI,不确定病例一律转医生复核。这与AI自动化偏倚揭示的"盲目信任AI会拖累诊断"形成直接呼应。
3. 技术原理:医生智能体与患者智能体交互,多次运行测一致性
系统的评估链路可概括为"模拟交互 → 生成诊断 → 重复运行测稳定性 → 闸门分流”。输入是匿名化的电子病历数据(诊断、检验值、用药、体格检查等),处理流程由两个智能体接力完成:一个扮演医生,可主动追问、索取检验结果与查体发现;另一个扮演患者,按病历回应。医生智能体据此输出诊断及理由,覆盖阑尾炎、胆囊炎、肺炎、肺栓塞、尿路感染等疾病场景。
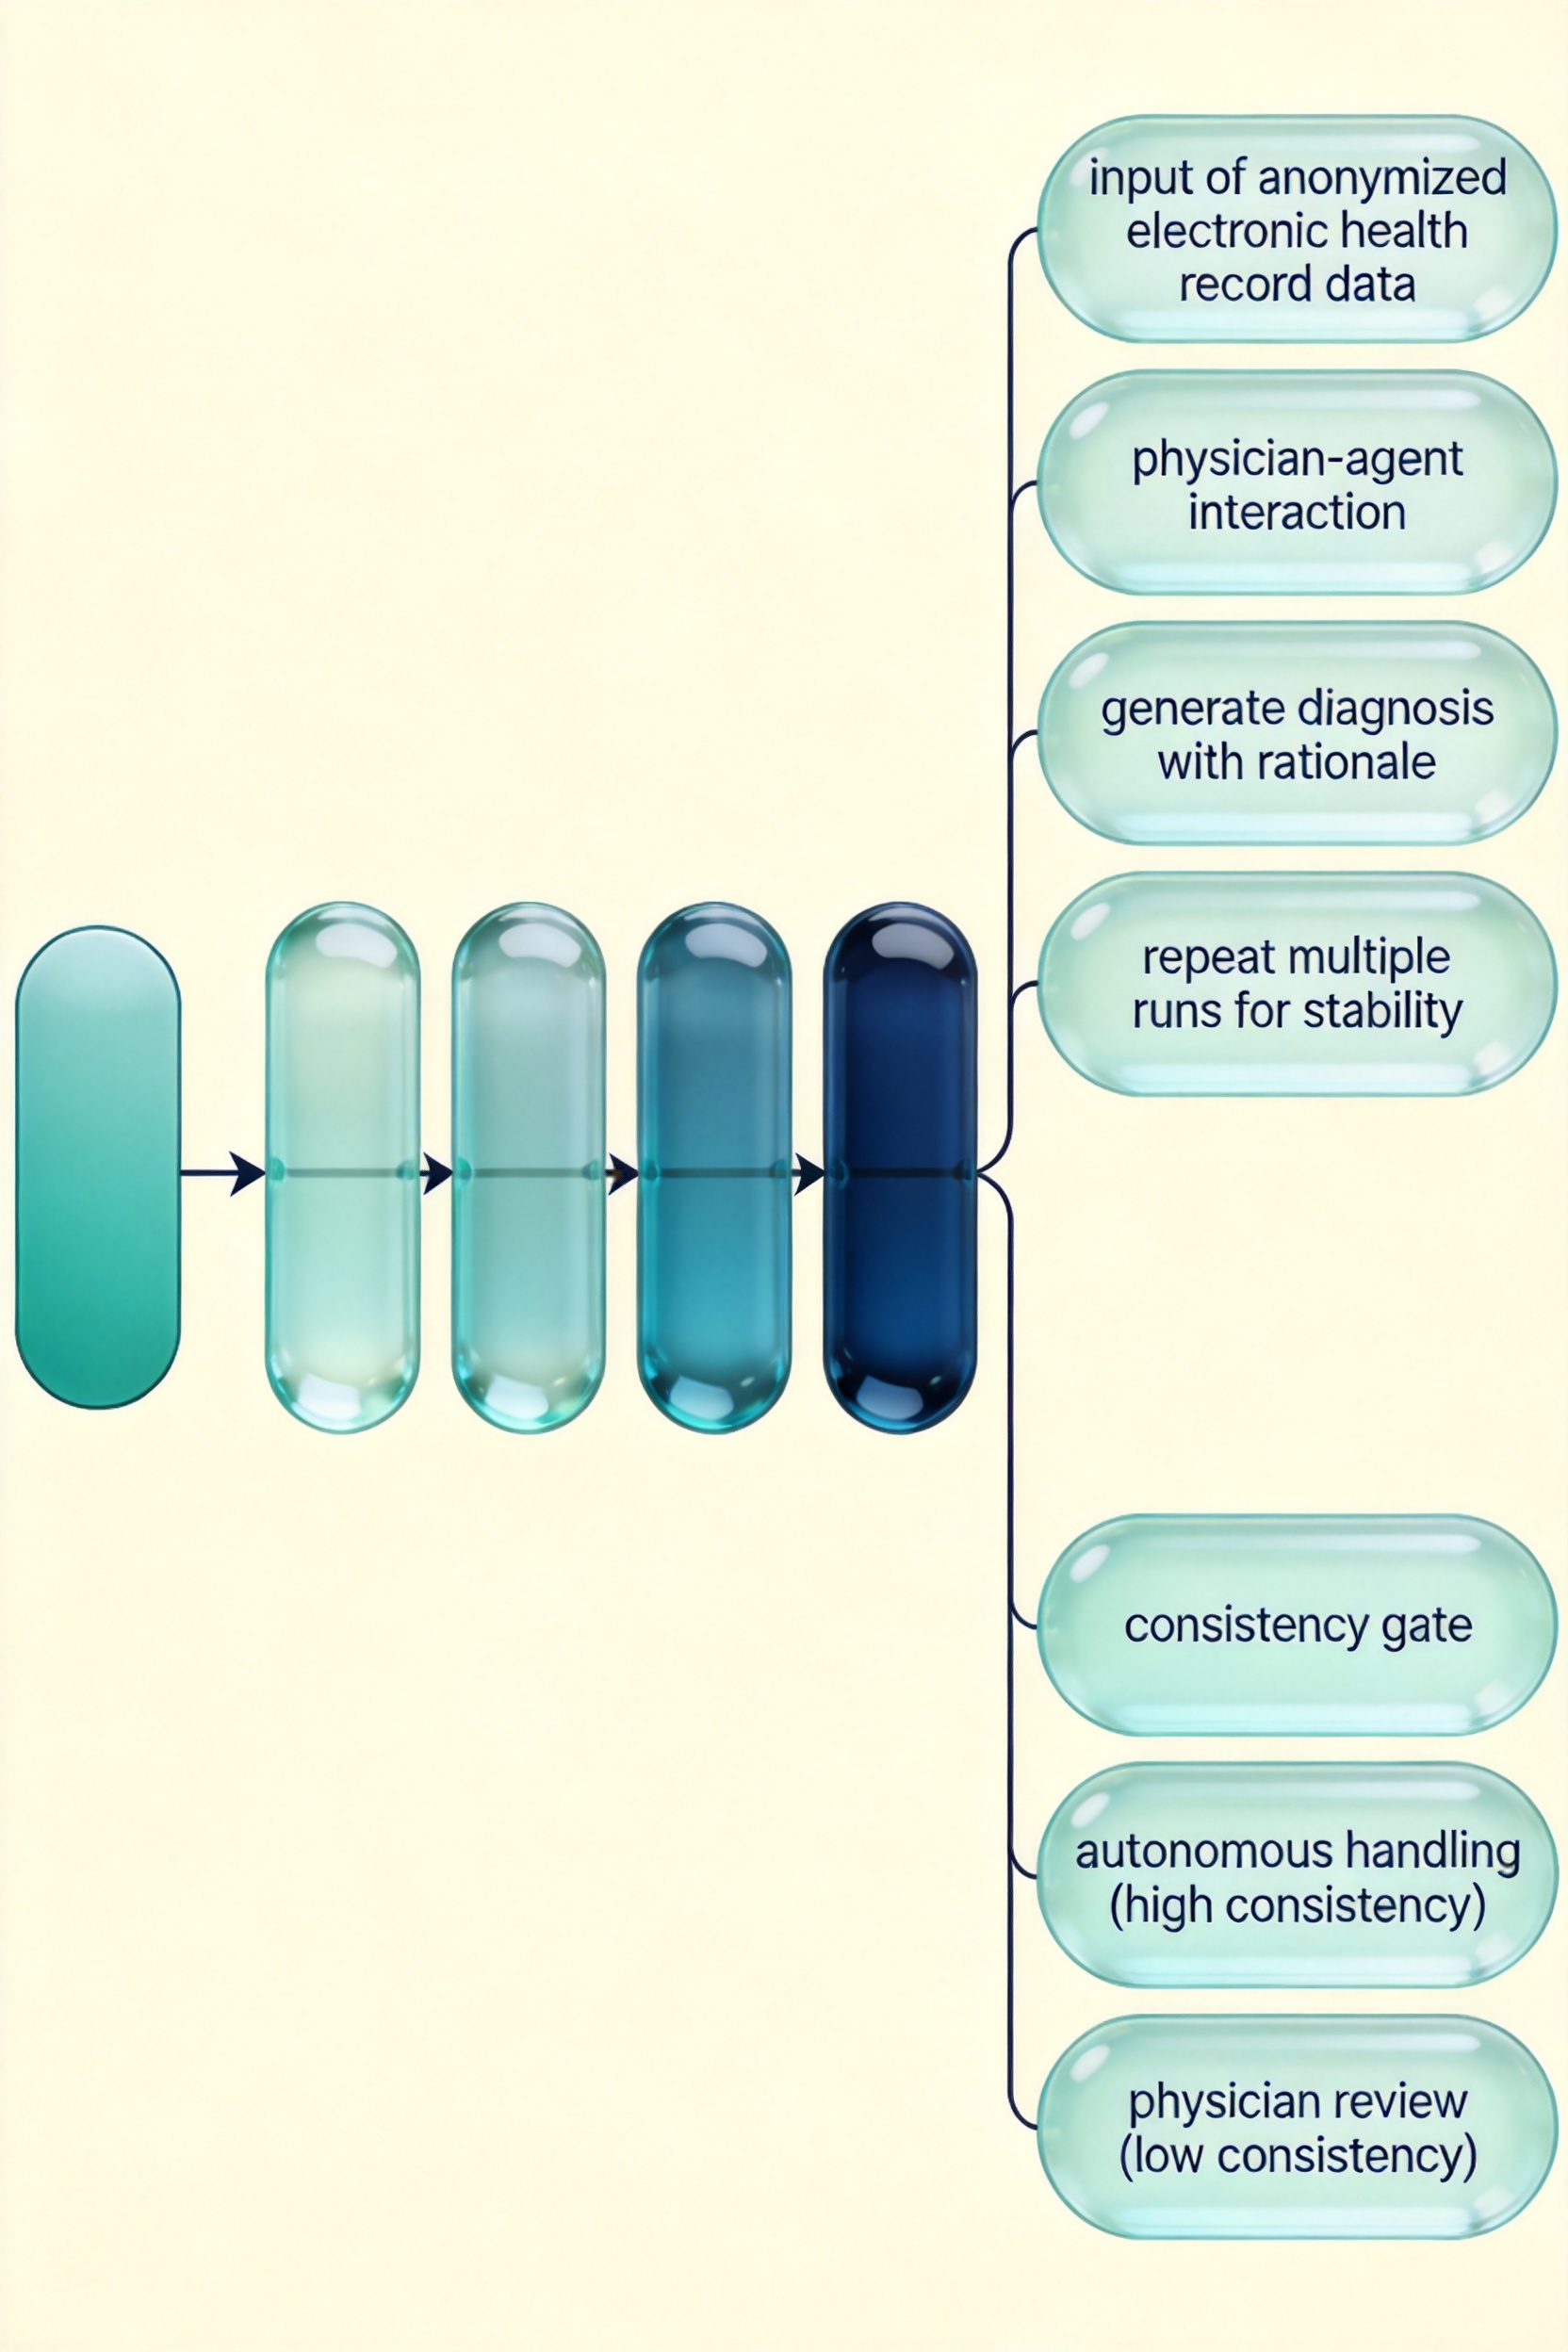
关键评价方法在"重复运行"这一步:对同一病例多次运行模型,观察诊断结果是否稳定。稳定意味着模型对该病例有把握,漂移则提示不确定。团队还做了压力测试——刻意移除可靠信息后,模型更易出错,但概率信号并未相应下降,进一步坐实了"自报置信度不可靠、行为一致性才可靠"的结论。
4. 数据说话:行为一致性是可信度的最佳探针
论文的核心数据可归纳为几组对比。
| 研究维度 | 比较对象 | 核心结果 |
|---|---|---|
| 诊断准确率(七病种基准) | 本地最佳模型 | 90.04% |
| 诊断准确率(七病种基准) | 云端基线 | 90.7% |
| 诊断准确率(四病种基准) | 本地模型 | 83.8% |
| 可信度区分能力(AUC) | 行为一致性信号 | 0.860(压力测试0.875) |
| 选择性自主 | 一致性阈值0.90 | 保留49.4%病例、准确率98.9% |
两组数字揭示了同一件事:本地部署几乎不牺牲性能——90.04%与云端90.7%仅差不到一个百分点;而**“什么时候能自主"是可以用数据回答的**——以行为一致性0.90为闸门,系统保留了49.4%的病例自主处理,这部分诊断准确率达98.9%,仅残留3例自主错误。此外,在181例随机病例上,自动评估与医生共识的一致率超过90%。需要强调,这是回顾性基准研究,数据来自MIMIC-IV衍生的两个基准,论文未报告P值与置信区间,准确率反映的是模拟环境下的诊断表现,不等同于真实临床或获批产品。
5. 从实验室到临床:应用前景与局限
这项研究为医疗机构提供了三条可能的应用路径:一是数据不出院的本地化部署,满足对数据主权有硬性要求的机构;二是把"一致性闸门"作为人机协作的调度机制,让AI处理常规、高把握的病例,把复杂、低把握的病例留给医生;三是为急诊场景的临床决策支持提供"何时该转人工"的量化依据。但至少有三条局限必须正视。
其一,结论建立在MIMIC-IV衍生的回顾性基准上,是单一数据环境,尚未在真实临床流程中验证,作者也明确下一步要在真实条件、多病种、医生参与下再测。其二,模拟病例涉及老年患者时准确率明显更低,原因尚不清楚,提示年龄相关数据代表性存在缺口。其三,估算可靠性需要对每个病例重复运行多次,token与GPU消耗约为单次推理的五倍,临床规模化部署时的算力成本仍需消化。
6. 结论与产业启示
这项研究给出一个清晰信号:医疗AI落地不必在"全自动"与"全人工"之间二选一——用行为一致性这类可审计的可靠性信号做闸门,可以在保护数据主权的同时,实现"该自主的自主、该交人的交人"的选择性自主。
对医疗AI产业有三点可执行建议:一是把"可靠性信号"纳入产品设计,让系统在不确定时主动示警,而非一味追求单次准确率;二是优先支持开源权重模型与本地化部署,回应医疗机构对数据主权的刚性需求;三是正视重复推理带来的算力开销,在成本与可靠性之间寻找工程上的折中方案。
相关问题
Q:这套本地部署智能体现在能替代医生自主诊断吗?
A:不能。它是一项回顾性基准研究,尚未经过真实临床验证,也非获批产品。研究提出的"选择性自主"明确把不确定病例转交医生,作者强调诊断与治疗的责任始终由人承担。
Q:行为一致性为什么比模型自己报的概率更可靠?
A:论文在压力测试中发现,移除关键信息后模型更易出错,但其概率信号并未相应下降,说明"自报置信度"会失灵;而同一病例多次运行是否给出相同诊断,能更真实地反映模型对病例的把握程度,因此是更可靠的可信度信号。
Q:这套框架适合中国医疗环境吗?
A:有参考价值但仍需本地验证。中国医院对数据不出院、私有化部署的需求同样强烈,开源权重模型本地化运行的方向契合;但其结论基于MIMIC-IV单一数据环境,迁移到国内需重新做数据治理、病种覆盖与临床验证。
参考文献
- Zhang L, Wölflein G, Ferber D, et al. On-premise medical AI agents for reliable clinical decision-making. Nature Medicine. 2026. DOI: 10.1038/s41591-026-04609-x
- Topol E J. High-performance medicine: the convergence of human and artificial intelligence. Nature Medicine. 2019;25:44–56. DOI: 10.1038/s41591-018-0300-7
- Rajpurkar P, Chen E, Banerjee O, Topol E J. AI in health and medicine. Nature Medicine. 2022;28:31–38. DOI: 10.1038/s41591-021-01614-0
本文基于 On-premise medical AI agents for reliable clinical decision-making 的独立解读,仅供学术交流,不构成临床建议。
📄 论文原文信息
| 论文标题 | On-premise medical AI agents for reliable clinical decision-making |
| 作者 | Li Zhang, Georg Wölflein, Dyke Ferber, Junhao Liang, Zunamys I. Carrero, Xuewei Wu, Julien Vibert, Jan Clusmann, Lino Möhrmann, Elena E. Möhrmann, Catharina Wichmann, Fabian Wolf, Tim Lenz, Jakob Nikolas Kather |
| 期刊 | Nature Medicine |
| 发表时间 | 2026-09-15 |
| DOI | 10.1038/s41591-026-04609-x |
| PubMed | PMID: 42744896 |