CROWN:细胞病理通用视觉基础模型,千万级无标注细胞图自监督预训练
中山大学肿瘤防治中心团队在Nature Cancer发表通用细胞病理视觉基础模型CROWN:用DINOv2自监督框架在超1000万张细胞图像上无标注预训练,覆盖202个任务组合,48项贴片级分类准确率超95%、22项超98%。
核心要点
- 问题:细胞病理学是宫颈癌、甲状腺癌等筛查与确诊流程里最基础、也最耗人力的一环,阅片高度依赖医生经验,数据分散、标注口径不一,病理AI长期停在"一任务一模型",缺一个可跨任务复用的通用底座。
- 方法:中山大学肿瘤防治中心 Muyan Cai 团队构建通用细胞病理视觉基础模型 CROWN,用 DINOv2 自监督框架在超过 1000 万张细胞病理图像块上预训练,全程无需人工标注。
- 结果:在 202 个任务组合(分类、分割、检测、检索、全片级预测)上取得现有预训练编码器中的最佳总体表现;48 项贴片级分类评估准确率超 95%,其中 22 项超 98%。
- 意义:为宫颈细胞学、甲状腺细针穿刺、胸腹水脱落细胞、血液细胞等多类细胞病理任务提供可复用的通用视觉骨干,显著降低标注依赖与重复训练成本。
- 原文:A universal visual foundation model for computational cytopathology,Nature Cancer,2026-09-18
1. 细胞病理的临床挑战:病理AI诊断最基础也最耗人力的环节
细胞病理学(cytopathology)通过显微镜观察脱落细胞或细针穿刺(fine-needle aspiration,FNA)取得的细胞形态,来筛查和诊断疾病。宫颈癌筛查的巴氏涂片(Pap smear)、甲状腺结节的细针穿刺、胸腹水脱落细胞检查、外周血细胞分析,都属于这一范畴。
这个环节的痛点很集中。第一,阅片高度依赖病理医生的人工经验,一位医生每天要"过目"成百上千张细胞图像,肉眼寻找散在的异常细胞,工作量大、易疲劳,也容易漏检。第二,细胞病理数据分散在不同机构、不同疾病、不同制片方式里,标注口径五花八门,很多公开数据集体量小、标签不统一,难以直接拼起来训练模型。第三,现有病理AI多为"一任务一模型",换个病种、换个制片方式就得重新标注、重新训练。这让"病理AI诊断"长期停留在单点工具层面,缺一个能跨任务复用的通用底座。
2. CROWN的核心创新:不标注,让细胞图自己说话
研究由中山大学肿瘤防治中心 Muyan Cai 团队领衔,2026 年 9 月 18 日在线发表于 Nature Cancer。模型名为 CROWN(Cytology visual foundation netwoRk Optimized With self-supervised learNing),创新集中在三点。
第一,自监督预训练,彻底摆脱人工标注。团队用 DINOv2 自监督框架,在超过 1000 万张细胞病理图像块上预训练,全程不需要任何人工标注。这与术中病理基础模型 CRISP的思路一脉相承——用海量无标注数据先学会"细胞长什么样",再迁移到具体任务。
第二,统一多种细胞病理模态。CROWN 把宫颈细胞学、甲状腺细针穿刺、胸腹水脱落细胞、血液细胞等不同来源、不同制片方式的细胞图像统一进一个预训练体系,形成一个通用的视觉骨干(backbone),避免每种制片方式各训一套。
第三,一个骨干跑通多类任务。评估覆盖 202 个任务组合,从贴片级分类、分割、检测,到图像检索、全片级(slide-level)预测,CROWN 无需针对每个任务从头训练,只需在通用骨干上做轻量微调即可适配。
3. 技术原理:DINOv2自监督,把千万细胞图压成通用骨干
CROWN 的核心机制可概括为"自监督对比学习 + 通用骨干迁移"。预训练阶段,模型对每一张细胞图像块生成两个经过不同增强的"视图",让同一图像的两个视图在特征空间里靠得近、不同图像的视图离得远,从而在没有标签的情况下学会细胞形态的通用特征。这一范式与ECG-CLIP 用对比学习对齐心电与报告在方法论上相通,只是 CROWN 纯视觉、不引入文本。
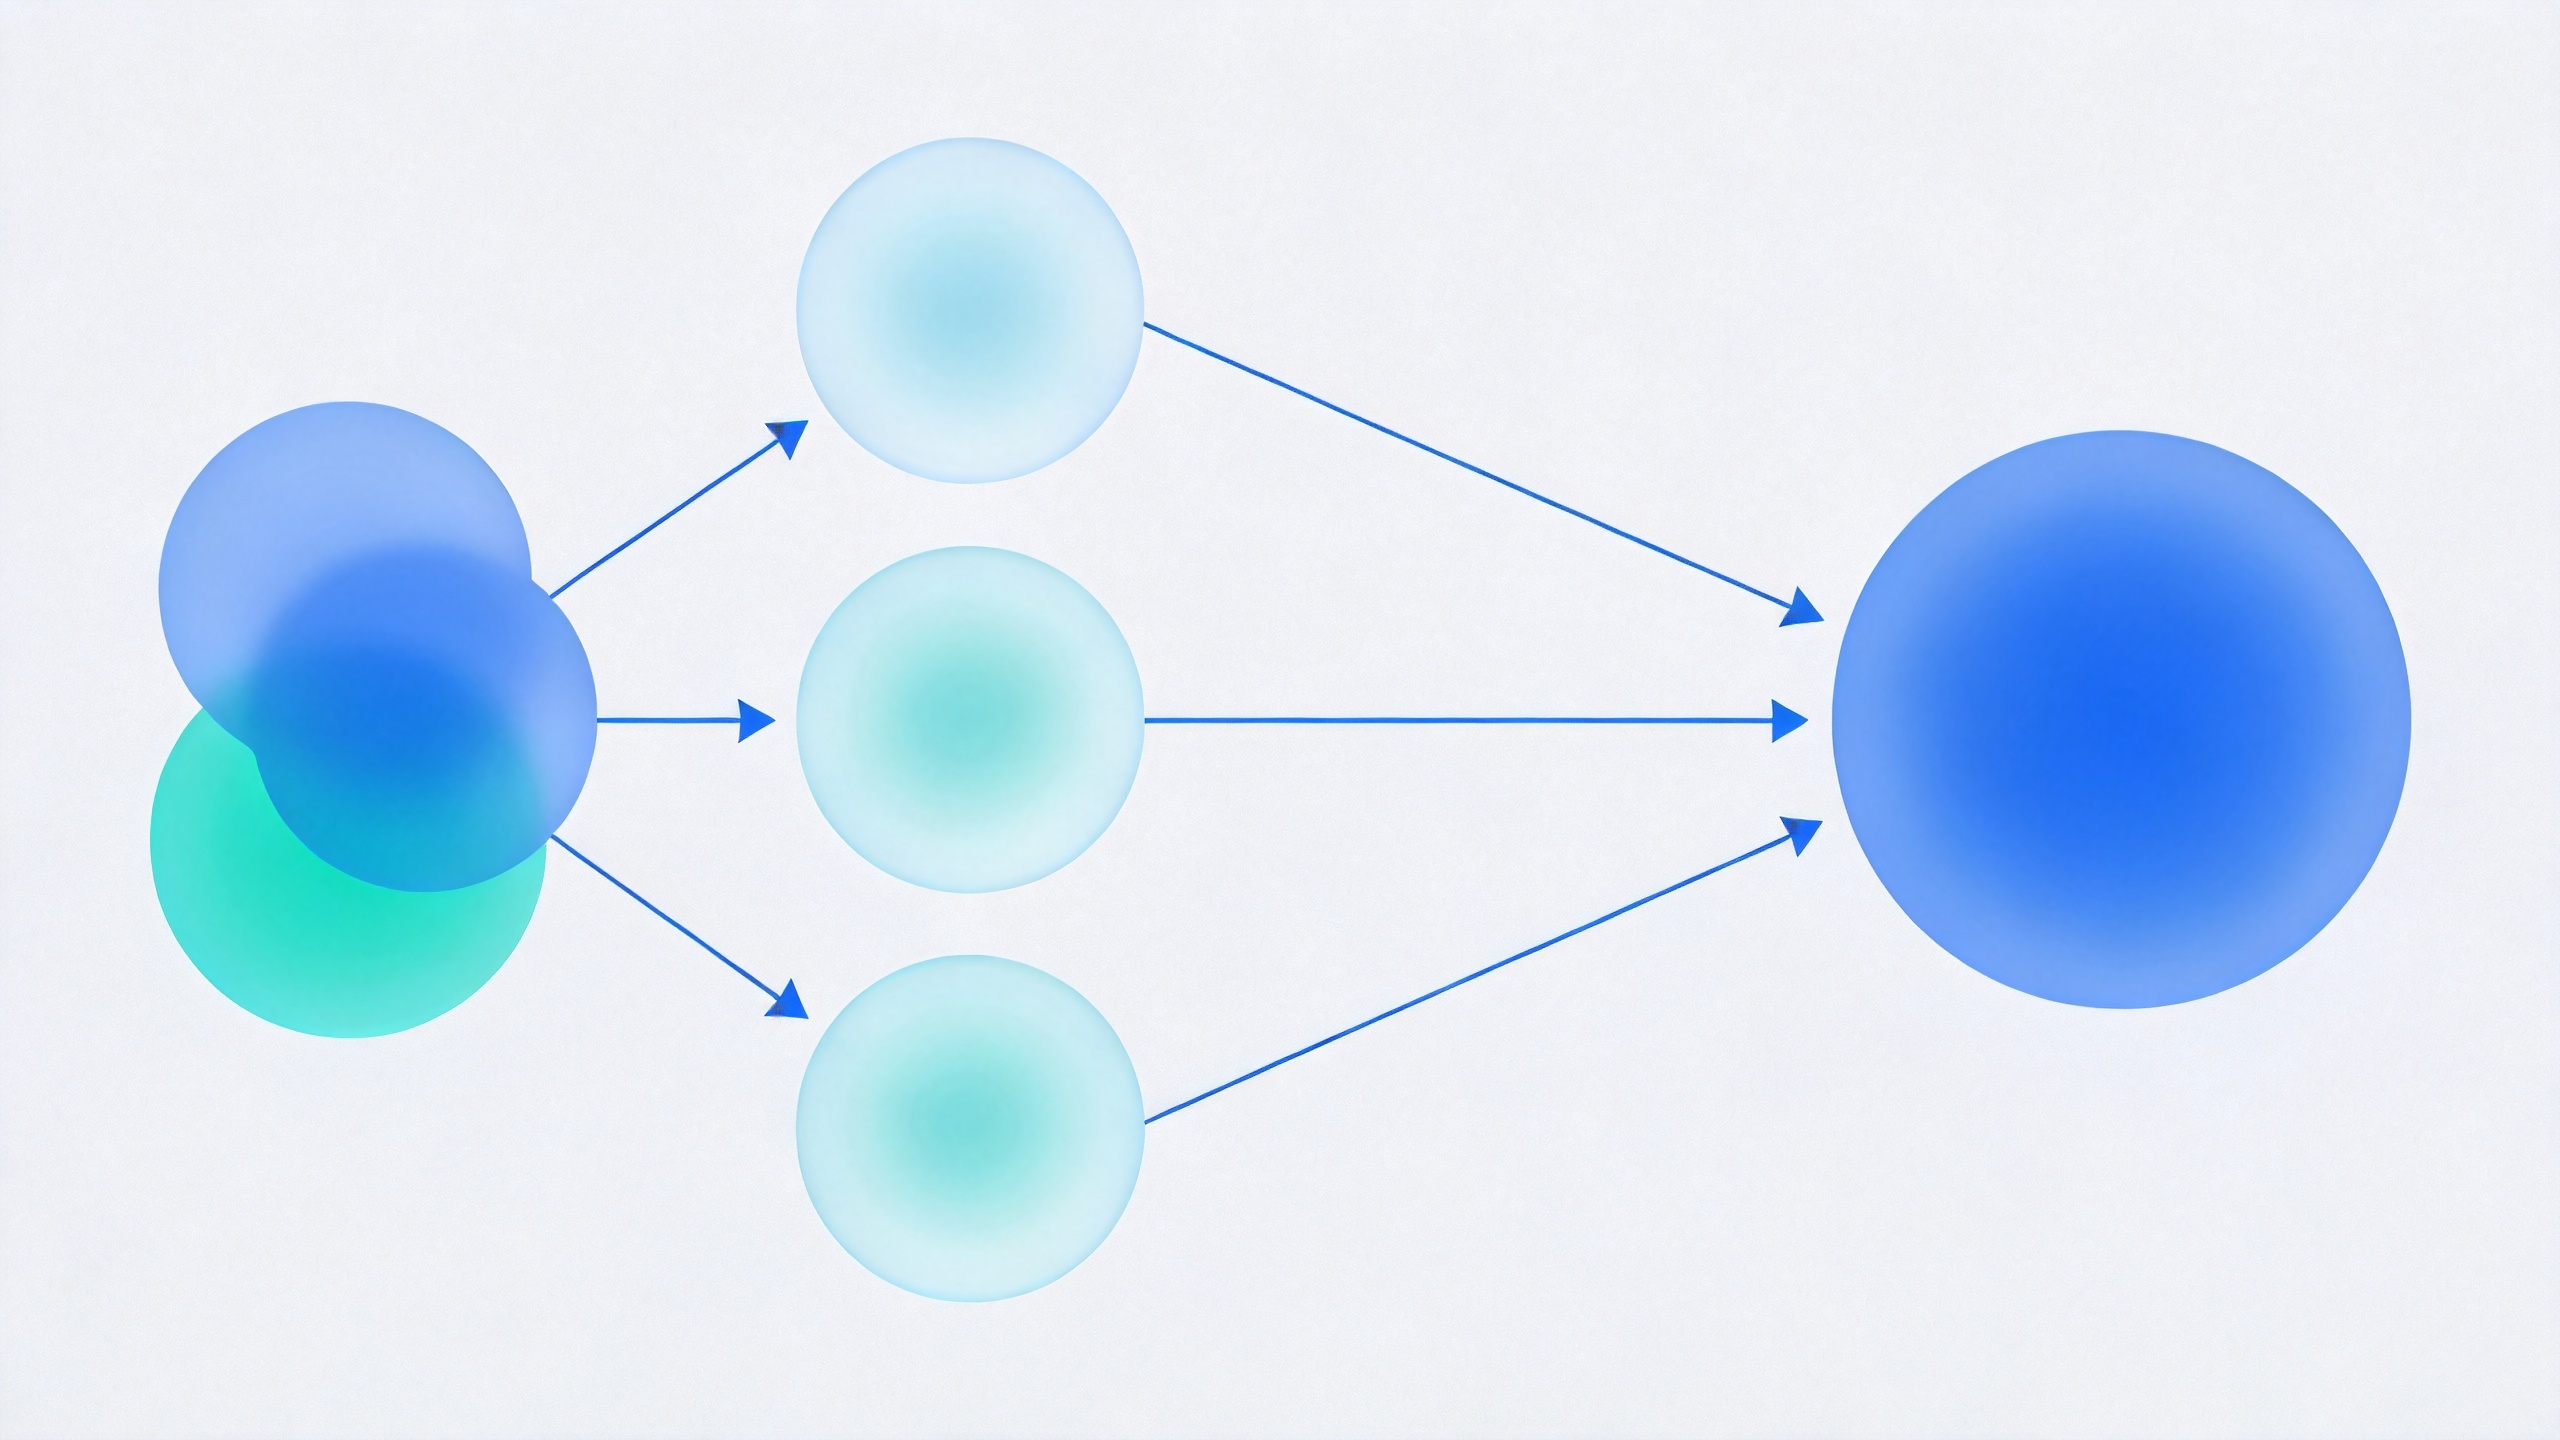
下游使用时,只需在 CROWN 骨干之上接一个轻量的任务头,就能完成分类、分割、检测等不同任务,省去从零训练的成本。需要强调,这是研究原型模型,论文评估的是其在多任务基准上的表现,而非一个已完成注册、可投入临床的获批产品。
4. 数据说话:202个任务组合总体最佳,22项分类超98%
论文核心结果可归纳为几组对比。
| 研究维度 | 比较对象 | 核心结果 |
|---|---|---|
| 任务覆盖 | 分类/分割/检测/检索/全片预测 | 202 个任务组合 |
| 贴片级分类(48 项) | CROWN vs 现有预训练编码器 | 准确率超 95% |
| 贴片级分类(22 项) | 同上 | 准确率超 98% |
| 总体表现 | vs 既有骨干 | 多数基准上最佳 |
这些评估横跨私人机构队列与公开数据集(宫颈细胞学 Cervix 1–5、甲状腺、胸腹水、血液等多个数据集),CROWN 在多数基准上取得现有预训练编码器中的最佳总体表现:48 项贴片级分类评估准确率超 95%,其中 22 项超 98%。需要强调的是,这是回顾性基准研究,未经过前瞻性临床验证,也未测量对真实诊疗流程或患者结局的影响。
5. 从实验室到临床:应用前景与局限
可能的应用场景包括:作为宫颈癌筛查、甲状腺细针穿刺等细胞病理任务的通用骨干,降低单一病种模型的标注与训练成本;在基层与资源紧张地区辅助病理医生快速筛查可疑细胞;为图像检索、全片级风险分层等下游任务提供可复用的特征底座。
局限至少三条。其一,这是基准研究,未做前瞻性临床验证,从"基准分数高"到"临床能用"还有距离。其二,预训练数据不公开(涉及患者隐私与机构伦理),外部研究者难以直接复现或在其上继续预训练;跨机构、跨制片方式的泛化仍需更充分的独立外部验证。其三,细胞病理任务的异质性极高,同一模型在罕见病种、不同染色与扫描设备上的表现仍需逐一确认。
6. 结论与产业启示
CROWN 给出一个清晰信号:细胞病理AI可以告别"一病一标注”,用一个自监督训练出来的通用视觉骨干覆盖分类、分割、检测等 202 个任务组合,其中 48 项贴片级分类准确率超 95%、22 项超 98%。
对医疗AI产业有三点可执行建议:一是把自监督预训练作为降低病理AI标注门槛的优先路线;二是构建"通用骨干 + 轻量任务头"的研发范式,减少重复训练、加快多病种扩展;三是正视基准研究与临床落地之间的鸿沟,落地前补齐前瞻验证、独立外部测试与数据治理。归根结底,可靠的"医疗AI解决方案"仍须以严格的临床验证为前提,而非只看基准分数的高低。
相关问题
Q:CROWN 现在能直接用于临床细胞病理诊断吗?
A:不能。它是一项回顾性基准研究,未经过前瞻性临床验证,也非获批产品。论文证明的是其在多任务基准上的通用性与准确率,落地临床仍需补齐前瞻验证与注册审批。
Q:它测试的是通用模型,还是一个完整可用的临床产品?
A:是研究原型模型。论文评估的是通用视觉骨干在分类、分割、检测等基准上的表现,尚未经历产品化、注册与临床部署。
Q:这种自监督预训练路线对中国医疗环境有意义吗?
A:有参考价值。中国细胞病理同样面临标注贵、病种多的问题,用海量无标注细胞图自监督训练、再迁移到具体任务,方向契合;但其结论基于回顾性基准,迁移到国内仍需本地病种覆盖与前瞻验证。
参考文献
- Zheng X, Zheng K, Wang J, et al. A universal visual foundation model for computational cytopathology. Nature Cancer. 2026. DOI: 10.1038/s43018-026-01240-0
- Lu MY, Chen B, Williamson DFK, et al. A visual-language foundation model for computational pathology. Nature Medicine. 2024;30:863–874. DOI: 10.1038/s41591-024-02856-4
- Vorontsov E, Bozkurt A, Casson A, et al. A foundation model for clinical-grade computational pathology and rare cancers detection. Nature Medicine. 2024;30:2924–2935. DOI: 10.1038/s41591-024-03141-0
本文基于 A universal visual foundation model for computational cytopathology 的独立解读,仅供学术交流,不构成临床建议。
📄 论文原文信息
| 论文标题 | A universal visual foundation model for computational cytopathology |
| 作者 | Xueyi Zheng, Ke Zheng, Jue Wang, Xinke Zhang, Kai Li, Zihan Zhao, Chaofeng Li, Haohua Chen, Ruixuan Wang, Junpeng Lai, Bing Chu, Sha Fu, Dan Xie, Muyan Cai |
| 期刊 | Nature Cancer |
| 发表时间 | 2026-09-18 |
| DOI | 10.1038/s43018-026-01240-0 |